Construye un agente de IA con Python y LangGraph que diagnostica y recupera servicios
Inicia sesión para descargarConstruye paso a paso un agente local de IA con Python, Ollama, LangChain y LangGraph capaz de investigar fallos reales en una API. Aprenderás a reunir evidencia desde HTTP, logs, métricas y …
Contenido del tutorial ⌄
- Un HTTP 503 nos dice que algo falló. No nos dice por qué.
- El agente que vamos a construir
- De una función Python a una herramienta de IA
- Cómo funciona realmente tool calling
- LangChain sin magia: automatizar la orquestación que ya entendemos
- Un agente necesita evidencia, no intuiciones
- Cuando el LLM se equivoca aunque tenga herramientas
- Del prompt a un grafo que obliga a reunir evidencia
Un HTTP 503 nos dice que algo falló. No nos dice por qué.
Imagina que una aplicación empieza a devolver errores en uno de sus endpoints. Podríamos reiniciar servicios hasta que vuelva a funcionar, pero eso no sería diagnosticar: sería probar acciones sin entender primero el problema.
Si recibimos un código HTTP 503, el servidor respondió. Eso es distinto de no poder alcanzarlo.
Los logs pueden sugerirlo, pero una pista no sustituye una comprobación directa de la dependencia.
Observar un sistema y modificarlo son cosas diferentes. Reiniciar un servicio requiere una frontera de seguridad.
¿Cómo construimos un agente de IA capaz de investigar un incidente real sin darle libertad ilimitada sobre el sistema?
Vamos a construir el proyecto desde una herramienta HTTP pequeña hasta un agente local capaz de reunir evidencia, diagnosticar una dependencia caída, consultar una política de recuperación y detenerse antes de modificar el sistema.
Esa será la instrucción que recibirá el agente al final del tutorial. No tendremos que decirle manualmente que consulte PostgreSQL, que lea logs o que reinicie un servicio. Durante el tutorial iremos construyendo las reglas que determinan qué comprobaciones son obligatorias y qué acciones necesitan autorización.
El LLM será útil para interpretar evidencia, pero las reglas críticas de diagnóstico y seguridad también vivirán en código.
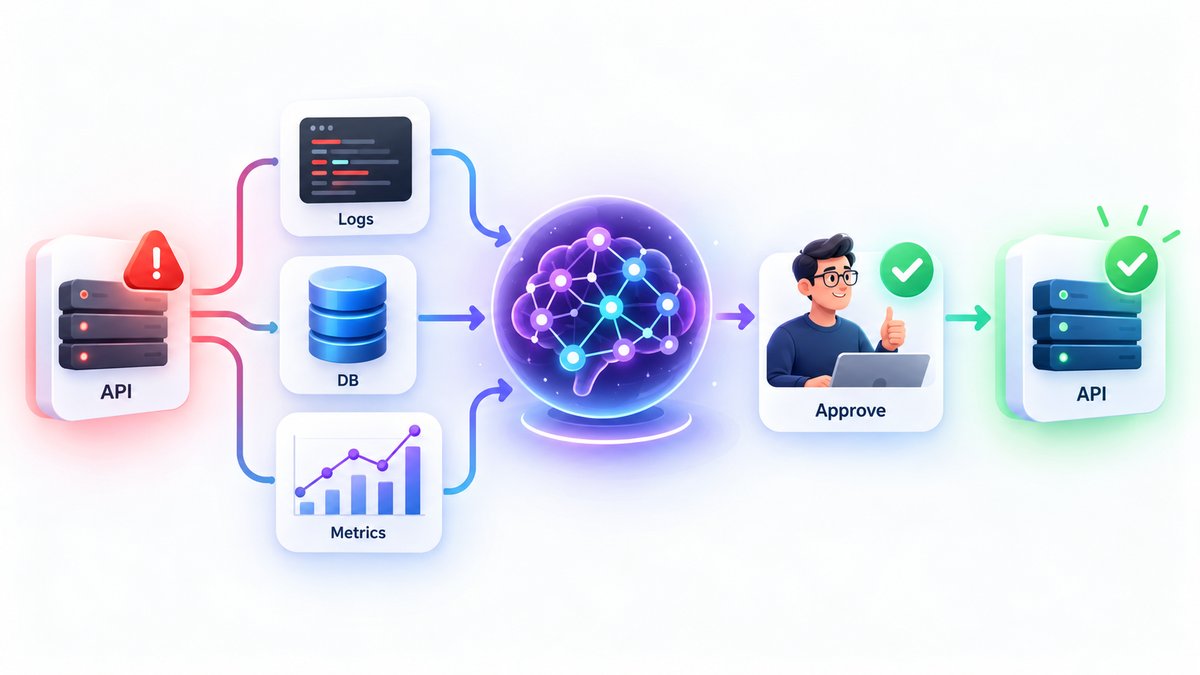
El agente que vamos a construir
Vamos a construir el sistema por capas. No empezaremos con LangGraph ni con un agente capaz de reiniciar servicios. Primero crearemos capacidades pequeñas y verificables; después iremos conectándolas hasta obtener un flujo completo de diagnóstico y recuperación.
HTTP, logs, PostgreSQL, métricas y runbooks nos permitirán observar diferentes partes del sistema sin modificar su estado.
Reiniciar PostgreSQL será una operación separada. El agente podrá proponerla, pero no ejecutarla antes de recibir una aprobación humana.
Antes de mostrar un archivo veremos cuál es su responsabilidad, qué recibe, qué produce y con qué otras piezas se conecta. Después veremos el código y comprobaremos su comportamiento.
De una función Python a una herramienta de IA
Antes de conectar un modelo necesitamos darle al programa una capacidad concreta. Empezaremos con algo pequeño pero fundamental: observar qué ocurre cuando intentamos acceder a un endpoint HTTP.
# archivo: src/agent_ops/tools/health.py

"""HTTP health-check tool used by the operations agent."""

from __future__ import annotations

import time
from typing import Any
from urllib.parse import urlparse

import httpx


def check_service(url: str, *, timeout: float = 5.0) -> dict[str, Any]:
    """Check whether an HTTP service is reachable and report its latency.

    The return value is deliberately JSON-serializable so it can later be sent
    back to a language model as the result of a tool call.
    """
    parsed = urlparse(url)

    if parsed.scheme not in {"http", "https"} or not parsed.netloc:
        return {
            "url": url,
            "reachable": False,
            "ok": False,
            "status_code": None,
            "latency_ms": 0.0,
            "error_type": "invalid_url",
            "error": "The URL must use http:// or https:// and include a host.",
        }

    if timeout <= 0:
        return {
            "url": url,
            "reachable": False,
            "ok": False,
            "status_code": None,
            "latency_ms": 0.0,
            "error_type": "invalid_timeout",
            "error": "timeout must be greater than zero.",
        }

    started_at = time.perf_counter()

    try:
        response = httpx.get(
            url,
            timeout=timeout,
            follow_redirects=True,
        )
    except httpx.RequestError as exc:
        elapsed_ms = (time.perf_counter() - started_at) * 1000

        return {
            "url": url,
            "reachable": False,
            "ok": False,
            "status_code": None,
            "latency_ms": round(elapsed_ms, 2),
            "error_type": type(exc).__name__,
            "error": str(exc),
        }

    elapsed_ms = (time.perf_counter() - started_at) * 1000

    return {
        "url": url,
        "reachable": True,
        "ok": response.is_success,
        "status_code": response.status_code,
        "latency_ms": round(elapsed_ms, 2),
        "error_type": None,
        "error": None,
}Porque para diagnosticar necesitamos conservar la evidencia. Dos situaciones pueden terminar en ok=false y aun así representar problemas completamente diferentes.
Si es true, conseguimos hablar con el servidor aunque haya respondido 404, 500 o 503.
Este campo nos permite separar una respuesta sana de una respuesta de error.
Conservar el código nos permite distinguir, por ejemplo, un 503 de una conexión que nunca consiguió llegar a HTTP.
Si no hubo respuesta podemos conservar información como un error de conexión y utilizarla después durante el diagnóstico.
reachable=true + status_code=503 significa que el servidor respondió HTTP. No significa que la API completa sea inalcanzable.
Más adelante veremos que confundir estas dos situaciones puede producir un diagnóstico incorrecto incluso cuando el modelo dispone de datos reales.
# archivo: src/agent_ops/runtime.py

"""Runtime paths shared by the lab API and diagnostic tools."""

from __future__ import annotations

import os
from pathlib import Path


def runtime_dir() -> Path:
    """Return the writable runtime directory used by the local lab."""
    configured = os.getenv("AGENT_OPS_RUNTIME_DIR")
    path = Path(configured) if configured else Path.cwd() / "runtime"
    path.mkdir(parents=True, exist_ok=True)
    return path


def lab_log_path() -> Path:
    return runtime_dir() / "lab-api.log"


def lab_pid_path() -> Path:
return runtime_dir() / "lab-api.pid"Una herramienta de diagnóstico necesita algo que observar. En lugar de experimentar contra un servicio real construiremos una API pequeña cuyos estados podamos provocar de forma controlada.
Porque queremos poder repetir exactamente los mismos incidentes mientras desarrollamos el agente. La reproducibilidad nos permite saber si una mejora del diagnóstico realmente funciona.
# archivo: src/agent_ops/lab_api.py

"""Deterministic HTTP service used to exercise the agent tools."""

from __future__ import annotations

import asyncio
import os
from contextlib import asynccontextmanager
from datetime import datetime, timezone
from pathlib import Path
from typing import AsyncIterator

from fastapi import FastAPI, HTTPException, Query

from agent_ops.runtime import lab_log_path, lab_pid_path
from agent_ops.tools.database import query_database


def _append_log(level: str, message: str, *, path: Path | None = None) -> None:
    target = path or lab_log_path()
    timestamp = datetime.now(timezone.utc).isoformat()
    with target.open("a", encoding="utf-8") as handle:
        handle.write(f"{timestamp} {level.upper()} {message}\n")


@asynccontextmanager
async def lifespan(_: FastAPI) -> AsyncIterator[None]:
    pid_path = lab_pid_path()
    pid_path.write_text(str(os.getpid()), encoding="utf-8")
    _append_log("INFO", f"lab-api started pid={os.getpid()}")

    try:
        yield
    finally:
        _append_log("INFO", f"lab-api stopped pid={os.getpid()}")
        try:
            if pid_path.read_text(encoding="utf-8").strip() == str(os.getpid()):
                pid_path.unlink(missing_ok=True)
        except OSError:
            pass


app = FastAPI(
    title="Agent Ops Lab API",
    version="0.2.0",
    description="API reproducible para probar herramientas y diagnósticos del agente.",
    lifespan=lifespan,
)


@app.get("/health")
async def health() -> dict[str, str]:
    """Return a healthy response."""
    _append_log("INFO", "GET /health status=200")
    return {
        "status": "ok",
        "service": "agent-ops-lab",
    }


@app.get("/slow")
async def slow(
    delay_ms: int = Query(default=1500, ge=0, le=5000),
) -> dict[str, str | int]:
    """Respond successfully after a controlled delay."""
    await asyncio.sleep(delay_ms / 1000)
    _append_log("WARNING", f"GET /slow status=200 delay_ms={delay_ms}")

    return {
        "status": "slow",
        "service": "agent-ops-lab",
        "delay_ms": delay_ms,
    }


@app.get("/error")
async def error() -> None:
    """Return an intentional server error for diagnostics."""
    _append_log("ERROR", "GET /error status=500 reason=intentional_lab_failure")
    raise HTTPException(
        status_code=500,
        detail="Intentional lab failure",
    )


@app.get("/database")
async def database() -> dict[str, str]:
    """Check the real PostgreSQL dependency used by the lab."""
    result = query_database(
        "SELECT current_database() AS database"
    )

    if not result["ok"]:
        _append_log(
            "ERROR",
            "GET /database status=503 "
            f"error_type={result['error_type']} error={result['error']!r}",
        )
        raise HTTPException(
            status_code=503,
            detail="Database dependency unavailable",
        )

    database_name = str(result["rows"][0]["database"])
    _append_log(
        "INFO",
        f"GET /database status=200 database={database_name}",
    )

    return {
        "status": "ok",
        "database": database_name,
}Con el entorno del proyecto activado, abre una terminal en la raíz del proyecto e inicia FastAPI. Déjala abierta porque utilizaremos una segunda terminal para provocar y observar diferentes estados.
python -m uvicorn agent_ops.lab_api:app `
  --host 127.0.0.1 `
--port 8000Abre otra terminal. Primero comprobaremos que la API puede estar sana, después introduciremos latencia y finalmente provocaremos un error HTTP de forma intencional.
Invoke-RestMethod `
  http://127.0.0.1:8000/health

Invoke-RestMethod `
  "http://127.0.0.1:8000/slow?delay_ms=1500"

try {
    Invoke-RestMethod `
      http://127.0.0.1:8000/error
}
catch {
    $_.Exception.Response.StatusCode.value__
}Cómo funciona realmente tool calling
Nuestra función Python sabe comprobar una URL, pero un modelo todavía no sabe que esa capacidad existe. El siguiente paso será exponerla como una herramienta que Ollama puede solicitar durante una conversación.
Un LLM no ejecuta una función Python solo por escribir su nombre. En tool calling el modelo genera una solicitud estructurada; después nuestra aplicación decide si esa solicitud está permitida y ejecuta la función real.
# fragmento de: src/agent_ops/ollama_agent.py

"""Minimal agent loop using Ollama directly, before introducing LangChain."""

from __future__ import annotations

import argparse
import json
import os
from collections.abc import Callable
from dataclasses import dataclass
from typing import Any
from urllib.parse import urlparse

import httpx

from agent_ops.tools import check_service

DEFAULT_OLLAMA_BASE_URL = os.getenv(
    "OLLAMA_BASE_URL",
    "http://127.0.0.1:11434",
).rstrip("/")
DEFAULT_MODEL = os.getenv("OLLAMA_MODEL", "qwen3.5:4b")

SYSTEM_PROMPT = """Eres un agente local de diagnóstico HTTP.
Cuando el usuario pida comprobar la API de laboratorio, usa check_service.
La única API autorizada está en http://127.0.0.1:8000.
Después de recibir el resultado de la herramienta, responde en español de forma
breve indicando si el servicio está sano y qué código HTTP devolvió.
Si hubo respuesta HTTP, puedes mencionar la latencia observada.
Si status_code es null o existe error_type, indica que el servicio no fue
alcanzable y NO describas latency_ms como latencia del servicio: en ese caso es
solo el tiempo transcurrido hasta detectar el fallo de conexión.
"""DEFAULT_OLLAMA_BASE_URL indica dónde está ejecutándose Ollama y DEFAULT_MODEL selecciona el modelo local. Ambos valores pueden sobrescribirse mediante variables de entorno, por lo que la lógica del agente no queda atada permanentemente a una instalación concreta.
El SYSTEM_PROMPT tampoco ejecuta ninguna acción. Su trabajo es enseñarle al modelo cómo interpretar la evidencia que recibirá después.
El prompt distingue entre una respuesta HTTP y un fallo de conexión. Esa diferencia nace de check_service(), que construimos antes: el modelo recibe evidencia estructurada en lugar de tener que adivinar qué ocurrió.
# fragmento de: src/agent_ops/ollama_agent.py

CHECK_SERVICE_TOOL: dict[str, Any] = {
    "type": "function",
    "function": {
        "name": "check_service",
        "description": (
            "Comprueba disponibilidad, código HTTP y latencia de un endpoint "
            "de la API de laboratorio en http://127.0.0.1:8000."
        ),
        "parameters": {
            "type": "object",
            "properties": {
                "url": {
                    "type": "string",
                    "description": (
                        "URL HTTP completa de la API de laboratorio. "
                        "Debe usar 127.0.0.1 y el puerto 8000."
                    ),
                }
            },
            "required": ["url"],
        },
    },
}CHECK_SERVICE_TOOL describe una capacidad que el modelo puede solicitar. Le dice cómo se llama la herramienta, para qué sirve y qué argumento debe proporcionar.
Si el modelo necesita comprobar la API, puede producir una solicitud equivalente a:
{
  "tool_calls": [
    {
      "function": {
        "name": "check_service",
        "arguments": {
          "url": "http://127.0.0.1:8000/health"
        }
      }
    }
  ]
}No podemos tomar cualquier nombre de función y cualquier argumento generado por el modelo y ejecutarlos sin control.
Antes de llegar a check_service(), nuestra aplicación comprobará dos cosas: que la herramienta solicitada está autorizada y que la URL pertenece al laboratorio local.
# fragmento de: src/agent_ops/ollama_agent.py

def _validate_lab_url(url: str) -> None:
    """Restrict the tutorial tool to the local lab API.

    This deliberately demonstrates that an LLM should not receive unrestricted
    network access just because it can generate a URL.
    """
    parsed = urlparse(url)

    try:
        port = parsed.port
    except ValueError as exc:
        raise ValueError("Invalid port in tool URL.") from exc

    if (
        parsed.scheme != "http"
        or parsed.hostname != "127.0.0.1"
        or port != 8000
    ):
        raise ValueError(
            "check_service is restricted to http://127.0.0.1:8000."
        )


def execute_tool(name: str, arguments: dict[str, Any]) -> dict[str, Any]:
    """Execute one allowlisted tool requested by the model."""
    if name != "check_service":
        raise ValueError(f"Unknown or unauthorized tool: {name}")

    url = arguments.get("url")
    if not isinstance(url, str):
        raise ValueError("check_service requires a string 'url' argument.")

    _validate_lab_url(url)
return check_service(url)El modelo puede proponer llamar a check_service y generar los argumentos necesarios.
execute_tool() comprueba el nombre de la herramienta y _validate_lab_url() restringe el destino al laboratorio.
La autoridad sigue estando en nuestro código. El modelo puede solicitar una acción, pero no puede inventar una herramienta nueva ni convertir check_service en acceso arbitrario a Internet.
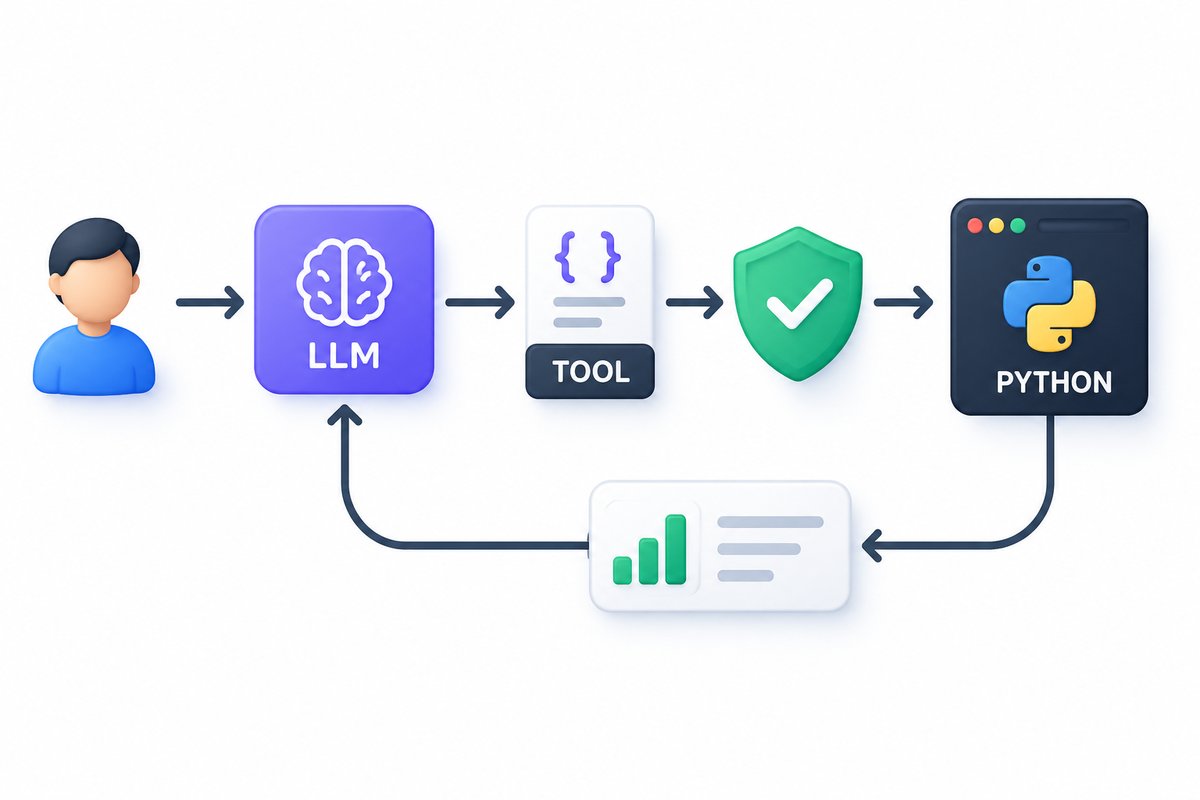
Hasta este punto el modelo conoce la descripción de check_service y nuestra aplicación sabe ejecutar esa herramienta de forma controlada.
Falta conectar ambos extremos: enviar mensajes y herramientas a Ollama, recibir un tool_call, ejecutar Python y devolver el resultado al modelo.
# fragmento de: src/agent_ops/ollama_agent.py

ChatCallable = Callable[..., dict[str, Any]]
ToolExecutor = Callable[[str, dict[str, Any]], dict[str, Any]]


@dataclass(frozen=True)
class AgentRun:
    """Observable result of one agent execution."""

    answer: str
    trace: list[dict[str, Any]]
    messages: list[dict[str, Any]]
model: strTambién conservamos la traza de herramientas utilizadas, todos los mensajes intercambiados y el modelo que participó en la ejecución.
Si un diagnóstico sale mal, necesitamos reconstruir qué pidió el modelo, qué ejecutó Python y qué evidencia recibió después.
# fragmento de: src/agent_ops/ollama_agent.py

def ollama_chat(
    *,
    messages: list[dict[str, Any]],
    tools: list[dict[str, Any]],
    model: str = DEFAULT_MODEL,
    base_url: str = DEFAULT_OLLAMA_BASE_URL,
) -> dict[str, Any]:
    """Call Ollama's native /api/chat endpoint."""
    payload = {
        "model": model,
        "messages": messages,
        "tools": tools,
        "stream": False,
        "think": False,
        "options": {
            "temperature": 0,
        },
    }

    with httpx.Client(timeout=180.0) as client:
        response = client.post(
            f"{base_url.rstrip('/')}/api/chat",
            json=payload,
        )
        response.raise_for_status()
        data = response.json()

    if not isinstance(data, dict) or not isinstance(data.get("message"), dict):
        raise RuntimeError("Ollama returned an unexpected response shape.")

return dataollama_chat() construye un payload y lo envía al endpoint /api/chat. Además de los mensajes, enviamos la descripción de las herramientas disponibles.
Incluye mensajes del sistema, usuario, modelo y resultados de herramientas.
Ollama conoce sus esquemas, pero Python continúa controlando su ejecución.
Para diagnóstico preferimos respuestas menos aleatorias.
Esperamos el mensaje completo antes de continuar con nuestro bucle.
La siguiente función convierte las piezas anteriores en un agente mínimo. Aquí veremos por primera vez el ciclo completo: modelo → herramienta → Python → resultado → modelo.
# fragmento de: src/agent_ops/ollama_agent.py

def run_health_agent(
    prompt: str,
    *,
    model: str = DEFAULT_MODEL,
    base_url: str = DEFAULT_OLLAMA_BASE_URL,
    max_steps: int = 4,
    chat_callable: ChatCallable = ollama_chat,
    tool_executor: ToolExecutor = execute_tool,
) -> AgentRun:
    """Run a small observe-act-observe loop until the model answers."""
    if max_steps < 1:
        raise ValueError("max_steps must be at least 1.")

    messages: list[dict[str, Any]] = [
        {
            "role": "system",
            "content": SYSTEM_PROMPT,
        },
        {
            "role": "user",
            "content": prompt,
        },
    ]
    trace: list[dict[str, Any]] = []
    tools = [CHECK_SERVICE_TOOL]

    for _ in range(max_steps):
        response = chat_callable(
            messages=messages,
            tools=tools,
            model=model,
            base_url=base_url,
        )
        raw_message = response["message"]

        assistant_message: dict[str, Any] = {
            "role": "assistant",
            "content": raw_message.get("content", ""),
        }

        tool_calls = raw_message.get("tool_calls") or []
        if tool_calls:
            assistant_message["tool_calls"] = tool_calls

        messages.append(assistant_message)

        if not tool_calls:
            return AgentRun(
                answer=assistant_message["content"],
                trace=trace,
                messages=messages,
                model=model,
            )

        for call in tool_calls:
            function = call.get("function") or {}
            name = function.get("name")
            arguments = function.get("arguments") or {}

            if not isinstance(name, str) or not isinstance(arguments, dict):
                raise RuntimeError("The model returned an invalid tool call.")

            result = tool_executor(name, arguments)

            trace.append(
                {
                    "tool": name,
                    "arguments": arguments,
                    "result": result,
                }
            )

            messages.append(
                {
                    "role": "tool",
                    "tool_name": name,
                    "content": json.dumps(result, ensure_ascii=False),
                }
            )

    raise RuntimeError(
        f"The agent did not produce a final answer after {max_steps} steps."
)El modelo no entra a Python ni ejecuta funciones por sí mismo. Conversa con nuestra aplicación mediante mensajes estructurados.
# fragmento de: src/agent_ops/ollama_agent.py

def main() -> None:
    parser = argparse.ArgumentParser(
        description="Run the P2 Ollama agent against the local lab API."
    )
    parser.add_argument(
        "prompt",
        nargs="?",
        default=(
            "Comprueba si http://127.0.0.1:8000/health está funcionando."
        ),
    )
    args = parser.parse_args()

    run = run_health_agent(args.prompt)

    for index, event in enumerate(run.trace, start=1):
        print(
            f"[tool {index}] {event['tool']}("
            f"{json.dumps(event['arguments'], ensure_ascii=False)})"
        )
        print(
            "[result] "
            f"{json.dumps(event['result'], ensure_ascii=False)}"
        )

    print(f"\nAgente: {run.answer}")


if __name__ == "__main__":
main()FastAPI debe seguir ejecutándose y Ollama debe estar disponible localmente. El modelo utilizado por defecto en este proyecto es qwen3.5:4b.
ollama pull qwen3.5:4b

python -m agent_ops.ollama_agent `
"Comprueba si http://127.0.0.1:8000/health está funcionando."LangChain sin magia: automatizar la orquestación que ya entendemos
Ahora que implementamos manualmente el protocolo, podemos introducir LangChain sin tratarlo como una caja negra. La herramienta seguirá siendo nuestra y las restricciones seguirán viviendo en nuestro código.
# fragmento de: src/agent_ops/langchain_agent.py

@tool("check_service")
def check_service_tool(url: str) -> dict[str, Any]:
    """Comprueba disponibilidad, código HTTP y latencia de la API local.

    Solo se permite acceder a la API de laboratorio en
    http://127.0.0.1:8000.
    """
    return execute_tool("check_service", {"url": url})


def build_agent(
    *,
    model_name: str = DEFAULT_MODEL,
    base_url: str = DEFAULT_OLLAMA_BASE_URL,
):
    """Build the LangChain agent without contacting Ollama yet."""
    model = ChatOllama(
        model=model_name,
        base_url=base_url,
        temperature=0,
        reasoning=False,
        validate_model_on_init=False,
    )

    return create_agent(
        model=model,
        tools=[check_service_tool],
        system_prompt=SYSTEM_PROMPT,
)Construíamos los mensajes, detectábamos tool_calls, ejecutábamos la herramienta y añadíamos manualmente el mensaje de resultado.
Declaramos una tool y creamos el agente, pero seguimos utilizando execute_tool(), por lo que nuestras restricciones permanecen intactas.
# fragmento de: src/agent_ops/langchain_agent.py

def run_langchain_agent(
    prompt: str,
    *,
    model_name: str = DEFAULT_MODEL,
    base_url: str = DEFAULT_OLLAMA_BASE_URL,
    agent: Any | None = None,
) -> LangChainRun:
    """Run one user request through the LangChain agent."""
    runtime = agent or build_agent(
        model_name=model_name,
        base_url=base_url,
    )

    result = runtime.invoke(
        {
            "messages": [
                {
                    "role": "user",
                    "content": prompt,
                }
            ]
        }
    )

    messages = result["messages"]
    if not messages:
        raise RuntimeError("LangChain returned no messages.")

    answer = messages[-1].content
    if not isinstance(answer, str):
        answer = str(answer)

    return LangChainRun(
        answer=answer,
        trace=extract_trace(messages),
        messages=messages,
        model=model_name,
)LangChain nos evita mantener manualmente parte del protocolo de mensajes y herramientas. No sustituye nuestras funciones, no decide nuestras políticas de seguridad y tampoco convierte automáticamente al agente en un buen diagnosticador.
python -m agent_ops.langchain_agent `
"Comprueba si http://127.0.0.1:8000/health está funcionando."Un agente necesita evidencia, no intuiciones
Hasta ahora el agente puede observar HTTP. Pero un código 503 no contiene suficiente información para explicar por qué ocurrió. Vamos a darle tres nuevas fuentes de evidencia: logs, métricas y PostgreSQL.
Permite leer únicamente los logs del servicio de laboratorio autorizado.
Separa las métricas de toda la máquina de las métricas específicas de lab-api.
Ejecuta consultas acotadas dentro de una transacción de solo lectura.
# archivo: src/agent_ops/tools/logs.py

"""Read recent logs from the local laboratory service."""

from __future__ import annotations

from pathlib import Path
from typing import Any

from agent_ops.runtime import lab_log_path

_ALLOWED_SERVICES = {"lab-api"}


def read_logs(
    service: str = "lab-api",
    *,
    lines: int = 50,
    path: Path | None = None,
) -> dict[str, Any]:
    """Return the last log lines for an allowlisted local service."""
    if service not in _ALLOWED_SERVICES:
        raise ValueError(f"Unknown or unauthorized service: {service}")

    if not 1 <= lines <= 200:
        raise ValueError("lines must be between 1 and 200.")

    target = path or lab_log_path()
    if not target.exists():
        return {
            "service": service,
            "available": False,
            "lines": [],
            "error": f"Log file does not exist yet: {target}",
        }

    content = target.read_text(
        encoding="utf-8",
        errors="replace",
    ).splitlines()

    return {
        "service": service,
        "available": True,
        "lines": content[-lines:],
        "error": None,
}# archivo: src/agent_ops/tools/metrics.py
"""System and process metrics for the local laboratory."""
from __future__ import annotations
from pathlib import Path
from typing import Any
import psutil
from agent_ops.runtime import lab_pid_path
_ALLOWED_SERVICES = {"lab-api"}
def get_system_metrics(
service: str = "lab-api",
*,
pid_path: Path | None = None,
) -> dict[str, Any]:
"""Return host metrics and, when available, lab API process metrics."""
if service not in _ALLOWED_SERVICES:
raise ValueError(f"Unknown or unauthorized service: {service}")
memory = psutil.virtual_memory()
result: dict[str, Any] = {
"service": service,
"host": {
"scope": "host_system",
"cpu_percent": psutil.cpu_percent(interval=0.1),
"memory_percent": memory.percent,
"memory_available_mb": round(
memory.available / 1024 / 1024,
2,
),
},
"process": {
"scope": "lab_api_process",
"running": False,
"pid": None,
"status": None,
"memory_percent": None,
"memory_rss_mb": None,
},
}
target = pid_path or lab_pid_path()
if not target.exists():
return result
try:
pid = int(
target.read_text(
encoding="utf-8"
).strip()
)
process = psutil.Process(pid)
process_memory = process.memory_info()
result["process"] = {
"scope": "lab_api_process",
"running": process.is_running(),
"pid": pid,
"status": process.status(),
"memory_percent": round(
process.memory_percent(),
3,
),
"memory_rss_mb": round(
process_memory.rss / 1024 / 1024,
2,
),
}
except (ValueError, psutil.Error):
return result
return resulthost.memory_percent describe toda la máquina. process.memory_percent y process.memory_rss_mb describen únicamente el proceso de nuestra API.
Una máquina con mucha memoria ocupada no demuestra que nuestra aplicación sea la responsable.
# fragmento de: src/agent_ops/tools/database.py

_MAX_ROWS = 50

_FORBIDDEN_TOKENS = re.compile(
    r"\b(insert|update|delete|merge|alter|drop|create|truncate|grant|revoke|"
    r"copy|vacuum|analyze|refresh|reindex|cluster|call|do)\b",
    flags=re.IGNORECASE,
)


def _validate_read_only_sql(sql: str) -> str:
    """Apply a narrow SQL policy before PostgreSQL's read-only transaction."""
    query = sql.strip()

    if not query:
        raise ValueError("SQL query cannot be empty.")

    if ";" in query.rstrip(";"):
        raise ValueError("Only one SQL statement is allowed.")

    query = query.rstrip(";").strip()

    if not re.match(
        r"^(select|with)\b",
        query,
        flags=re.IGNORECASE,
    ):
        raise ValueError("Only SELECT or WITH queries are allowed.")

    if _FORBIDDEN_TOKENS.search(query):
        raise ValueError("Potentially mutating SQL is not allowed.")

return query# fragmento de: src/agent_ops/tools/database.py
def query_database(
sql: str,
*,
database_url: str | None = None,
connect_factory: Callable[..., Any] = psycopg.connect,
) -> dict[str, Any]:
"""Execute one bounded query inside a PostgreSQL read-only transaction."""
query = _validate_read_only_sql(sql)
dsn = database_url or DEFAULT_DATABASE_URL
try:
with connect_factory(
dsn,
connect_timeout=3,
row_factory=dict_row,
autocommit=True,
) as connection:
with connection.cursor() as cursor:
cursor.execute("BEGIN READ ONLY")
cursor.execute(
"SET LOCAL statement_timeout = '2000ms'"
)
cursor.execute(query)
columns = (
[column.name for column in cursor.description]
if cursor.description
else []
)
rows = (
cursor.fetchmany(_MAX_ROWS + 1)
if cursor.description
else []
)
truncated = len(rows) > _MAX_ROWS
rows = rows[:_MAX_ROWS]
cursor.execute("ROLLBACK")
return {
"ok": True,
"columns": columns,
"rows": rows,
"row_count": len(rows),
"truncated": truncated,
"error_type": None,
"error": None,
}
except psycopg.Error as exc:
return {
"ok": False,
"columns": [],
"rows": [],
"row_count": 0,
"truncated": False,
"error_type": type(exc).__name__,
"error": str(exc),
}No dependemos de una instrucción como “por favor, no modifiques la base de datos”. La política también está codificada.
# fragmento de: src/agent_ops/diagnostic_agent.py

@tool("check_service")
def check_service_tool(url: str) -> dict[str, Any]:
    """Comprueba estado HTTP y latencia de la API local autorizada."""
    from agent_ops.ollama_agent import _validate_lab_url

    _validate_lab_url(url)
    return check_service(url)


@tool("read_logs")
def read_logs_tool(
    service: str = "lab-api",
    lines: int = 30,
) -> dict[str, Any]:
    """Lee las últimas líneas de logs del servicio local lab-api."""
    return read_logs(service, lines=lines)


@tool("get_system_metrics")
def get_system_metrics_tool(
    service: str = "lab-api",
) -> dict[str, Any]:
    """Obtiene CPU, memoria y estado del proceso lab-api."""
    return get_system_metrics(service)


@tool("query_database")
def query_database_tool(sql: str) -> dict[str, Any]:
    """Ejecuta una consulta PostgreSQL acotada dentro de una transacción read-only."""
return query_database(sql)# fragmento de: src/agent_ops/diagnostic_agent.py
def build_diagnostic_agent(
*,
model_name: str = DEFAULT_MODEL,
base_url: str = DEFAULT_OLLAMA_BASE_URL,
):
"""Build the P4 LangChain diagnostic agent."""
model = ChatOllama(
model=model_name,
base_url=base_url,
temperature=0,
reasoning=False,
validate_model_on_init=False,
)
return create_agent(
model=model,
tools=[
check_service_tool,
read_logs_tool,
get_system_metrics_tool,
query_database_tool,
],
system_prompt=DIAGNOSTIC_SYSTEM_PROMPT,
)Antes el agente tenía una sola herramienta. Ahora puede comprobar HTTP, leer logs, observar métricas y consultar PostgreSQL.
Eso parece una mejora evidente, pero introduce una pregunta mucho más difícil: ¿podemos confiar en que el LLM reúna siempre la evidencia correcta?
docker compose stop postgres

Invoke-RestMethod `
  http://127.0.0.1:8000/health

try {
    Invoke-RestMethod `
      http://127.0.0.1:8000/database
}
catch {
    $_.Exception.Response.StatusCode.value__
}FastAPI sigue respondiendo. Lo que falla es el endpoint que depende de PostgreSQL.
Por ahora nuestra mejor descripción es: API viva con una dependencia posiblemente no disponible.
Todavía necesitamos comprobar PostgreSQL directamente antes de convertir esa posibilidad en una conclusión.
Cuando el LLM se equivoca aunque tenga herramientas
Darle más información al modelo no garantiza que la utilice correctamente. Durante la construcción de este proyecto aparecieron tres errores especialmente útiles porque terminaron cambiando la arquitectura.
El agente observó una utilización de memoria muy alta en el host y la trató como posible explicación principal del incidente.
Pero el proceso de FastAPI consumía mucha menos memoria. Una métrica global de la máquina no demostraba que nuestra API fuera responsable.
Los logs mostraban errores de conexión hacia PostgreSQL y el modelo podía concluir que la base de datos estaba caída sin ejecutar una prueba directa.
Si investigamos /database, comprobar PostgreSQL con SELECT 1 AS ok debe ser obligatorio.
La herramienta podía devolver reachable=true y status_code=503, pero el modelo describía la situación como si toda la API estuviera caída.
Si recibimos 503, hubo una respuesta HTTP. El problema puede encontrarse en una dependencia del endpoint y no en el proceso web completo.
Podríamos continuar añadiendo más reglas al system prompt: “comprueba siempre PostgreSQL”, “no confundas host y proceso”, “interpreta correctamente reachable”.
Pero algunas reglas son demasiado importantes para depender únicamente de que un modelo las recuerde durante cada ejecución.
La siguiente versión del agente moverá esas decisiones desde el prompt hacia la arquitectura.
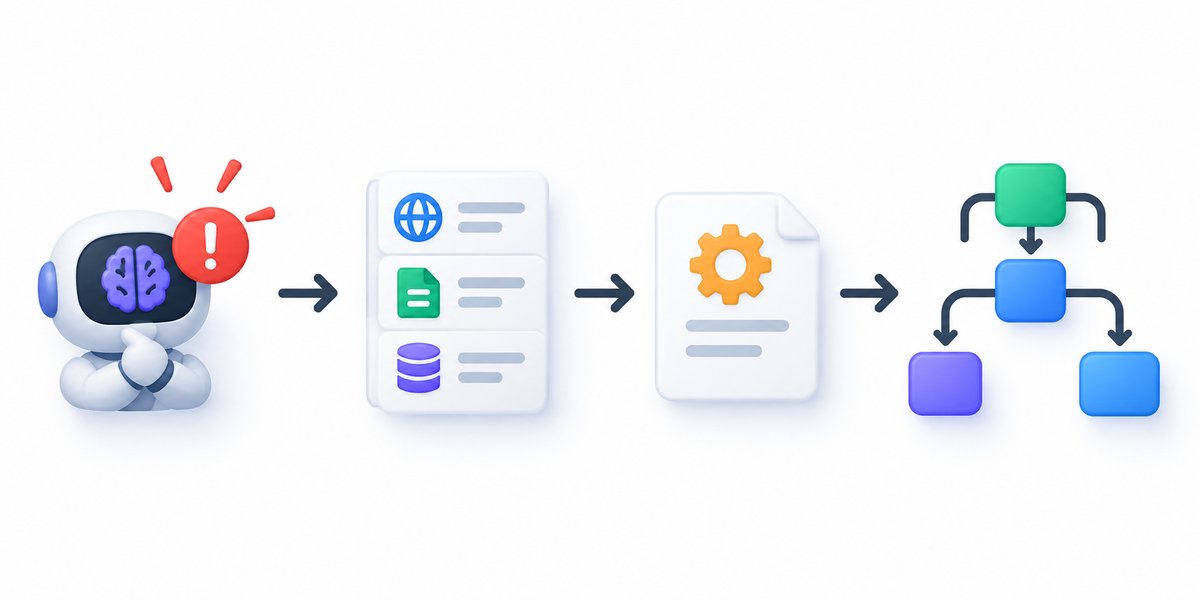
Del prompt a un grafo que obliga a reunir evidencia
Hasta ahora el modelo podía decidir qué herramientas utilizar. LangGraph nos permitirá mover parte de esa responsabilidad hacia un flujo explícito: determinadas comprobaciones ocurrirán porque el sistema las exige, no porque el LLM recuerde hacerlas.
Comentarios y valoraciones
No hay comentarios aún. ¡Sé el primero en opinar!