Python 3.15 desde cero: instalación, seis novedades y pruebas reales
Inicia sesión para descargarDescubre Python 3.15 con un laboratorio práctico en Windows. Instala el lenguaje sin eliminar versiones anteriores, prueba seis novedades con código ejecutable y aprende a identificar cuellos de botella con Tachyon mediante …
Contenido de la guía ⌄
- Python 3.15: una nueva etapa para el lenguaje
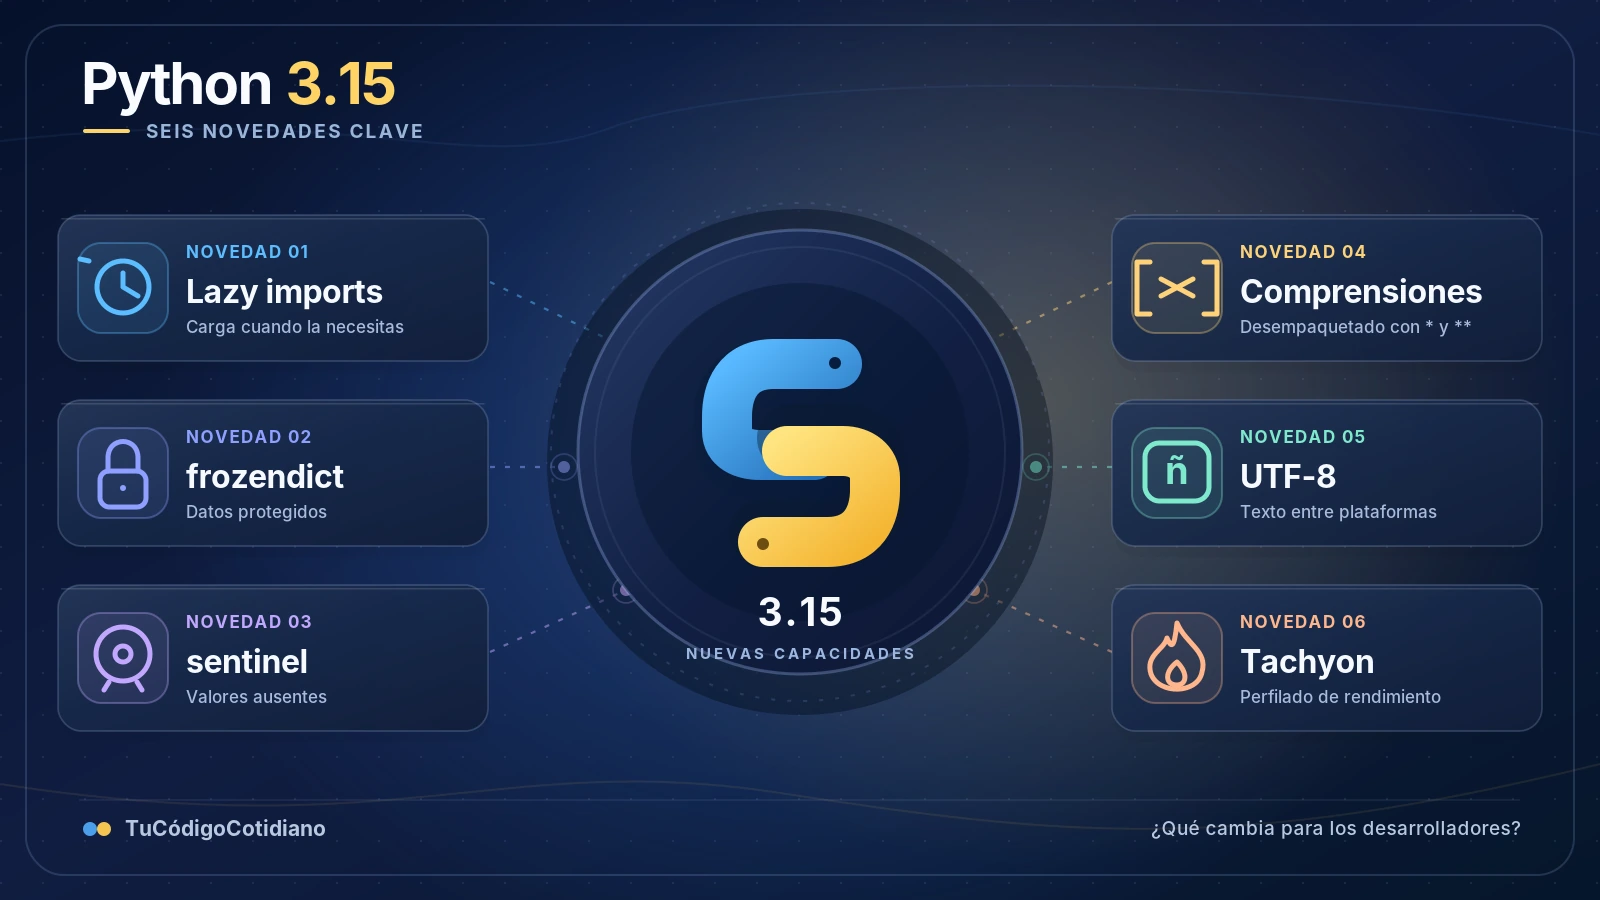
- ¿Cuáles son las principales novedades de Python 3.15?
- ¿Por qué Python 3.15 es una actualización interesante?
- Lazy imports: cargar módulos solamente cuando se necesitan
- Un módulo que tarda dos segundos en cargarse
- Importación tradicional: el trabajo ocurre al principio
- Lazy import: aplazar el trabajo hasta el primer uso
- ¿Qué encontramos al medir ambas importaciones?
- ¿Cuándo conviene utilizar lazy imports?
- frozendict: diccionarios que no permiten modificar sus entradas
- ¿Qué ocurrió al intentar modificarlo?
- ¿Significa que todo su contenido queda congelado?
- sentinel: distinguir un valor ausente de None
- ¿Qué demostró nuestro experimento?
- ¿Por qué utilizamos el operador is?
- Dos herramientas nuevas para escribir código más predecible
- Unpacking en comprensiones: combinar colecciones con menos código
- ¿Qué comprobamos con las nuevas comprensiones?
- ¿Cuándo es útil el desempaquetado en comprensiones?
- UTF-8 por defecto: menos problemas con tildes, eñes y emojis
- La prueba: el mismo archivo en dos versiones de Python
NOVEDADES · PYTHON 3.15
Python 3.15: una nueva etapa para el lenguaje
Python 3.15 llegó el 9 de octubre de 2026 con nuevas herramientas para escribir código más expresivo, mejorar el arranque de aplicaciones y analizar su rendimiento.
Esta versión introduce importaciones diferidas, diccionarios inmutables, valores centinela, nuevas posibilidades para las comprensiones y el uso predeterminado de UTF-8.
También incorpora Tachyon, un perfilador estadístico que permite descubrir dónde consume tiempo un programa.
Analizaremos las novedades más relevantes, explicaremos qué problemas resuelven, veremos ejemplos breves y comentaremos cuándo merece la pena aprovecharlas en proyectos reales.
Para complementar esta revisión, probamos seis de las novedades utilizando Python 3.15.0. Por eso incluiremos observaciones reales cuando ayuden a comprender su funcionamiento.
CAMBIOS DESTACADOS
¿Cuáles son las principales novedades de Python 3.15?
Python 3.15 no se concentra en una única característica. Sus mejoras abarcan el sistema de importaciones, los tipos incorporados, la sintaxis, el manejo de archivos y las herramientas de diagnóstico.
La nueva sintaxis lazy import permite posponer la carga de módulos hasta que se necesitan. Puede reducir el tiempo inicial de algunas aplicaciones.
Un nuevo tipo de diccionario inmutable que evita modificar sus entradas después de crearlo. Resulta útil para configuraciones y datos compartidos.
Permite crear marcadores únicos para distinguir un valor ausente de valores válidos como None.
Las comprensiones ahora permiten desempaquetar elementos con * y **, simplificando ciertas operaciones de combinación de datos.
Python utiliza UTF-8 como codificación predeterminada, reduciendo problemas relacionados con caracteres especiales entre plataformas.
Un perfilador estadístico integrado que permite investigar cuellos de botella y visualizar el comportamiento de un programa.
Estos son seis de los cambios más relevantes para quienes programan habitualmente en Python. La versión también incluye mejoras internas, nuevas capacidades de tipado y cambios orientados al rendimiento.
¿Por qué Python 3.15 es una actualización interesante?
Muchas actualizaciones de un lenguaje se perciben principalmente a través de pequeñas mejoras de rendimiento o correcciones internas.
Python 3.15 combina esas mejoras con herramientas que afectan directamente a la manera de escribir y analizar código.
frozendict, sentinel y las nuevas comprensiones permiten comunicar mejor determinadas intenciones sin depender de soluciones auxiliares.
Lazy imports ayuda a gestionar cuándo se cargan los módulos. Tachyon facilita identificar en qué partes se concentra la ejecución de un programa.
Entre los avances adicionales destacan las mejoras del compilador JIT experimental, una ABI estable para compilaciones free-threaded, nuevos recursos de tipado y mensajes de error más útiles.
No necesariamente. En proyectos existentes también debemos considerar la compatibilidad de nuestras dependencias, el entorno de despliegue y las características que realmente necesitamos.
A continuación examinaremos cada novedad con ejemplos concretos y explicaciones que permitan valorar su utilidad.
NOVEDAD 01 · PEP 810
Lazy imports: cargar módulos solamente cuando se necesitan
Cuando iniciamos un programa de Python, es habitual que se importen varios módulos antes de ejecutar cualquier operación importante.
El problema aparece cuando una aplicación tiene muchas dependencias y necesita importar módulos que quizá nunca utilizará durante esa ejecución. La carga inicial puede consumir tiempo y memoria sin aportar un beneficio inmediato.
Python 3.15 incorpora una solución mediante importaciones diferidas, también conocidas como lazy imports.
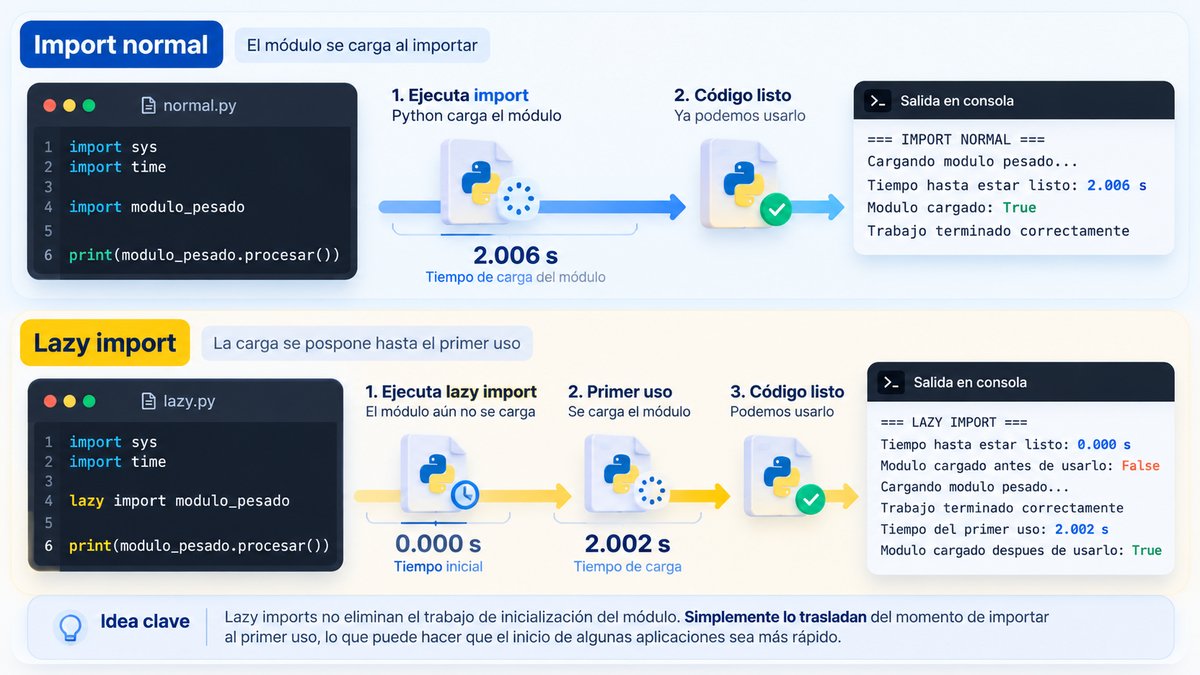
En una importación tradicional, Python carga y ejecuta el código inicial del módulo inmediatamente. Con lazy import, puede aplazar ese trabajo hasta el primer uso del nombre importado.
El módulo se carga al ejecutar la instrucción import, incluso si todavía no utilizamos sus funciones.
La carga se pospone hasta que necesitamos utilizar el nombre importado por primera vez.
Este cambio resulta especialmente interesante para herramientas de línea de comandos, aplicaciones con muchos módulos y programas que ofrecen funcionalidades opcionales.
La característica se describe oficialmente en la PEP 810: Explicit Lazy Imports .
Un módulo que tarda dos segundos en cargarse
Para entender la diferencia, creamos
un módulo llamado
modulo_pesado.py.
Este módulo contiene una función sencilla, pero incorpora deliberadamente una espera de dos segundos durante su inicialización.
La espera es artificial: no representa el rendimiento de una biblioteca real. Nos permite observar con claridad en qué momento ocurre la carga.
Si importamos este módulo sin utilizarlo inmediatamente, ¿Python debe esperar esos dos segundos desde el principio, o puede continuar y cargarlo más tarde?
import time

print("Cargando modulo pesado...")
time.sleep(2)

def procesar():
    return "Trabajo terminado correctamente"
Importación tradicional: el trabajo ocurre al principio
Una importación convencional ejecuta la inicialización del módulo cuando se alcanza la instrucción import.
En nuestro ejemplo, Python muestra el mensaje de carga y espera dos segundos antes de continuar.
Para comprobarlo, utilizamos
time.perf_counter()
y consultamos sys.modules,
el registro de módulos cargados
del intérprete.
import sys
import time

print("=== IMPORT NORMAL ===")

inicio = time.perf_counter()

import modulo_pesado

tiempo_inicio = time.perf_counter() - inicio

print(f"Tiempo hasta estar listo: {tiempo_inicio:.3f} s")
print(f"Modulo cargado: {'modulo_pesado' in sys.modules}")
print(modulo_pesado.procesar())
Lazy import: aplazar el trabajo hasta el primer uso
Ahora sustituimos la importación convencional
por la nueva sintaxis de Python 3.15:
lazy import modulo_pesado.
El módulo ya no necesita ejecutar inmediatamente todo su código inicial. Python conserva una referencia diferida que se resuelve cuando utilizamos el nombre importado.
Esto significa que el programa puede avanzar sin realizar todavía el trabajo de inicialización.
La carga diferida no hace desaparecer el trabajo necesario para importar un módulo. Simplemente cambia el momento en que ocurre.
import sys
import time

print("=== LAZY IMPORT ===")

inicio = time.perf_counter()

lazy import modulo_pesado

tiempo_inicio = time.perf_counter() - inicio

print(f"Tiempo hasta estar listo: {tiempo_inicio:.3f} s")
print(f"Modulo cargado antes de usarlo: {'modulo_pesado' in sys.modules}")

inicio_uso = time.perf_counter()

print(modulo_pesado.procesar())

tiempo_uso = time.perf_counter() - inicio_uso

print(f"Tiempo del primer uso: {tiempo_uso:.3f} s")
print(f"Modulo cargado despues de usarlo: {'modulo_pesado' in sys.modules}")
¿Qué encontramos al medir ambas importaciones?
Ejecutamos los dos programas por separado utilizando Python 3.15.0. Estas fueron las mediciones registradas en nuestro laboratorio.
Con una importación normal, nuestro programa esperó aproximadamente dos segundos durante la carga inicial. Con lazy import, esa espera se trasladó al momento de utilizar el módulo.
Por tanto, el beneficio potencial aparece cuando una aplicación importa módulos que no necesita utilizar inmediatamente o que quizá nunca utilizará durante una ejecución concreta.
Esto puede mejorar la experiencia de arranque de determinadas aplicaciones, aunque no significa que todos los programas se ejecutarán más rápido.
¿Cuándo conviene utilizar lazy imports?
Las importaciones diferidas pueden ser útiles en aplicaciones que tienen muchas dependencias, pero no necesitan todas sus funcionalidades durante cada ejecución.
Una herramienta de línea de comandos puede evitar cargar componentes innecesarios cuando el usuario solamente consulta su ayuda.
Las bibliotecas asociadas a funciones poco utilizadas pueden permanecer sin inicializarse hasta ser necesarias.
Posponer algunas importaciones puede reducir el trabajo realizado durante el arranque de una aplicación.
Algunos flujos de trabajo pueden evitar importar módulos que no intervienen en la operación solicitada.
Si un módulo debe ejecutar su inicialización inmediatamente, aplazarla podría cambiar el comportamiento esperado. Además, ciertos errores de importación pasarían a manifestarse durante el primer uso.
La nueva sintaxis lazy solamente se permite a nivel de módulo. No puede utilizarse directamente dentro de funciones, clases ni bloques try.
Tampoco es una sintaxis compatible con versiones anteriores a Python 3.15. Por eso resulta importante revisar las versiones que debe soportar una biblioteca antes de adoptarla.
En resumen: lazy imports es una herramienta para controlar cuándo se realiza el trabajo de importación, no una forma de eliminar su costo.
Referencia técnica: Documentación oficial de Python 3.15 — PEP 810 .
NOVEDAD 02 · PEP 814
frozendict: diccionarios que no permiten modificar sus entradas
Los diccionarios son una de las estructuras de datos más utilizadas en Python. Permiten almacenar información mediante pares de claves y valores, pero tienen una característica importante: son mutables.
Esto significa que podemos agregar, modificar o eliminar sus elementos en cualquier momento.
Esa flexibilidad resulta útil en muchas situaciones, aunque también puede convertirse en un problema cuando necesitamos que ciertos datos permanezcan intactos.
Imagina una aplicación que utiliza una configuración compartida con el servidor, el puerto de conexión y el modo de depuración.
Si una parte del programa modifica accidentalmente esa configuración, podría alterar el comportamiento de otros componentes.
Python 3.15 introduce
frozendict,
un nuevo tipo incorporado que permite
construir diccionarios inmutables.
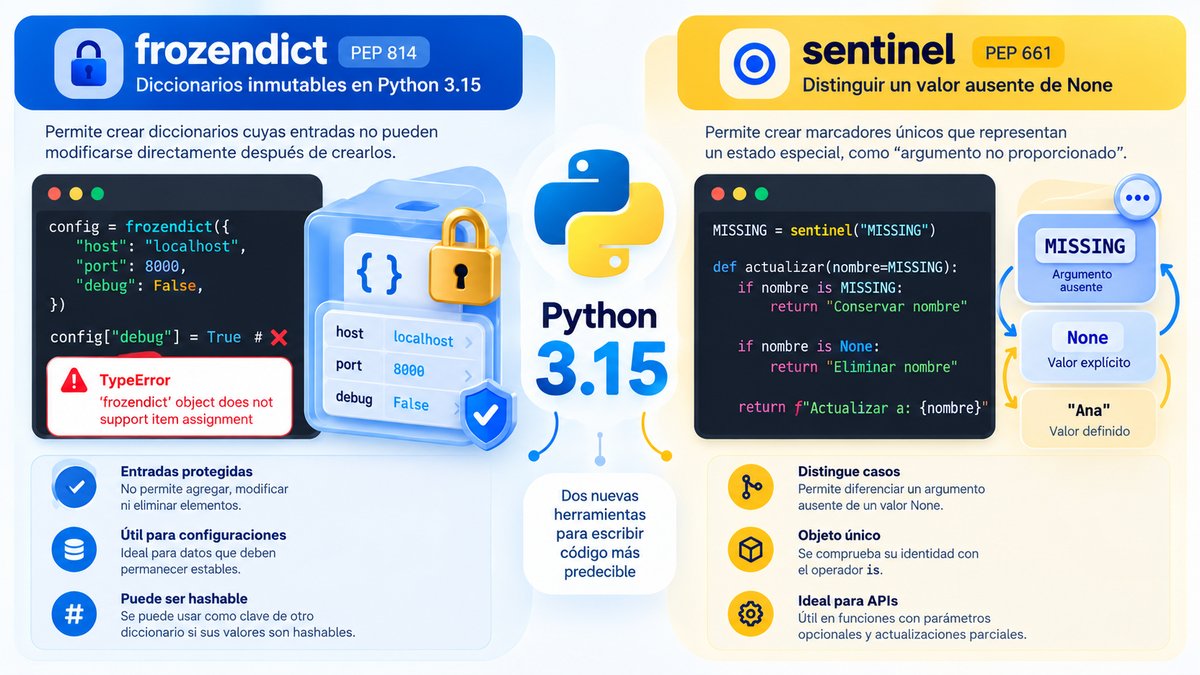
Podemos reasignar una clave, agregar elementos o eliminarlos después de crear el diccionario.
Una vez creado, no permite agregar, eliminar ni reasignar sus entradas directamente.
No necesitamos instalar una biblioteca
adicional ni realizar una importación:
frozendict está disponible
directamente entre los tipos incorporados
de Python 3.15.
Referencia oficial: PEP 814 — Add frozendict built-in type .
print("=== EXPERIMENTO 02: FROZENDICT ===")

normal = {"host": "localhost", "port": 8000, "debug": False}
normal["debug"] = True

print("dict modificable:", normal["debug"])

config = frozendict({
    "host": "localhost",
    "port": 8000,
    "debug": False,
})

print("Configuracion original:", config)

try:
    config["debug"] = True
except TypeError as error:
    print("Modificacion bloqueada:", type(error).__name__)
    print("Detalle:", error)

nueva = frozendict({**config, "debug": True})

print("Original sigue intacta:", config["debug"])
print("Nueva configuracion:", nueva["debug"])
print("Se puede usar como clave:", {config: "estable"}[config])
¿Qué ocurrió al intentar modificarlo?
Ejecutamos el ejemplo utilizando Python 3.15.0 y observamos una diferencia clara entre ambos tipos.
La asignación de un nuevo valor a la clave debug se completó correctamente.
Python impidió modificar directamente una entrada del objeto frozendict.
También comprobamos que podíamos construir una nueva configuración sin alterar la original.
Un frozendict puede utilizarse como clave de otro diccionario cuando tanto sus claves como sus valores son hashables.
En nuestra prueba utilizamos la configuración como clave y recuperamos correctamente el valor "estable".
¿Significa que todo su contenido queda congelado?
No. La inmutabilidad de frozendict es superficial: protege las entradas del propio diccionario, pero no transforma automáticamente en inmutables los objetos almacenados.
Por ejemplo, si uno de sus valores es una lista, los elementos de esa lista todavía pueden modificarse.
Además, frozendict no es una subclase de dict. Cuando una API acepta tipos de mapeo en general, puede ser más apropiado utilizar el protocolo collections.abc.Mapping.
¿Cuándo utilizarlo? En configuraciones que deben permanecer estables, estructuras compartidas, valores predeterminados inmutables y ciertos argumentos de funciones que utilizan caché.
frozendict protege frente a cambios directos de sus entradas; no debe confundirse con un mecanismo de seguridad para almacenar secretos.
NOVEDAD 03 · PEP 661
sentinel: distinguir un valor ausente de None
En Python, el valor None
se utiliza habitualmente para representar
la ausencia de información.
Sin embargo, existe una diferencia importante entre que un usuario no proporcione un argumento y que envíe explícitamente None.
Consideremos una función que permite actualizar el nombre de un usuario. Queremos distinguir tres situaciones.
No se proporcionó ningún valor. La función debería conservar el nombre existente.
El usuario proporcionó None intencionalmente. En este ejemplo, significa eliminar el nombre.
Se proporcionó un nuevo nombre. La función debe utilizar ese valor para actualizarlo.
Si utilizamos None como valor predeterminado de la función, no podemos distinguir los dos primeros casos solamente examinando ese parámetro.
El nuevo tipo incorporado
sentinel permite crear
un marcador único que representa
un estado especial, como
"argumento no proporcionado".
Podemos crear un marcador llamado MISSING y utilizarlo como valor predeterminado. De esta forma, None sigue siendo un valor válido y diferente del marcador.
MISSING = sentinel("MISSING")

def actualizar(nombre=MISSING):
    if nombre is MISSING:
        return "No se envio argumento: conservar nombre"

    if nombre is None:
        return "None explicito: eliminar nombre"

    return f"Actualizar nombre a: {nombre}"


print("=== EXPERIMENTO 03: SENTINEL ===")

print("Caso 1:", actualizar())
print("Caso 2:", actualizar(None))
print("Caso 3:", actualizar("Ana"))

print("Marcador:", repr(MISSING))
¿Qué demostró nuestro experimento?
Ejecutamos el ejemplo en Python 3.15.0 y obtuvimos tres respuestas diferentes.
Al ejecutar actualizar(), el parámetro mantiene el marcador MISSING.
Al ejecutar actualizar(None), reconocemos que None se proporcionó explícitamente.
Al ejecutar actualizar("Ana"), la función identifica el nuevo valor.
La función repr() devuelve una representación breve y legible del marcador.
Nuestro ejemplo no modifica una base de datos real; devuelve mensajes para demostrar cómo se distinguen los argumentos.
¿Por qué utilizamos el operador is?
Un sentinel representa un objeto
único, por lo que conviene comprobar
su identidad mediante el operador
is.
Así podemos distinguir con claridad nuestro marcador MISSING de cualquier otro valor.
Define el marcador una sola vez, normalmente a nivel de módulo, y reutiliza el mismo objeto en las funciones que lo necesiten.
Recuerda que MISSING no es la cadena de texto "MISSING": es un objeto creado mediante sentinel("MISSING").
Esta característica puede resultar especialmente útil en APIs, actualizaciones parciales de datos, funciones con parámetros opcionales y bibliotecas que necesitan distinguir estados con precisión.
Referencia oficial: PEP 661 — Sentinel Values .
Dos herramientas nuevas para escribir código más predecible
Aunque frozendict y sentinel resuelven problemas diferentes, comparten una idea importante: permiten expresar con mayor precisión las intenciones de nuestro programa.
Lo utilizamos cuando queremos que las claves y sus asociaciones de valores permanezcan intactas después de crear la estructura.
Lo utilizamos cuando necesitamos distinguir un argumento ausente de un valor proporcionado explícitamente.
Ambos tipos son incorporaciones de Python 3.15. Si desarrollamos bibliotecas que también deben funcionar en versiones anteriores, necesitamos considerar alternativas compatibles antes de utilizar directamente estas novedades.
Estas herramientas no sustituyen a los diccionarios normales ni al valor None. Los complementan cuando necesitamos comportamientos más específicos.
A continuación veremos otra mejora relacionada con las colecciones: el desempaquetado dentro de comprensiones, que permite combinar elementos de una forma más expresiva.
NOVEDAD 04 · PEP 798
Unpacking en comprensiones: combinar colecciones con menos código
Las comprensiones son una de las características más utilizadas de Python. Permiten crear listas, conjuntos y diccionarios a partir de otros datos, utilizando expresiones compactas.
Sin embargo, cuando necesitamos combinar varias colecciones, la sintaxis tradicional puede requerir bucles anidados.
Por ejemplo, imaginemos que una aplicación organiza sus tecnologías en tres grupos: Python y Django, Docker y Linux, y finalmente PostgreSQL.
Queremos reunir todas esas tecnologías en una única lista, sin conservar las listas internas.
La PEP 798 permite utilizar los operadores de desempaquetado * y ** directamente al comienzo de las expresiones de determinadas comprensiones.
De esta manera, podemos combinar múltiples colecciones sin escribir explícitamente un segundo bucle.
Para aplanar listas, normalmente escribíamos un bucle para recorrer cada grupo y otro para obtener sus elementos.
Podemos expresar directamente que queremos incorporar todos los elementos de cada grupo a la colección resultante.
La nueva sintaxis también funciona con conjuntos, diccionarios y expresiones generadoras.
Cada colección conserva sus propias reglas: las listas mantienen el orden, los conjuntos eliminan duplicados y los diccionarios combinan claves y valores.
Especificación: PEP 798 — Unpacking in Comprehensions .
print("=== EXPERIMENTO 04: UNPACKING ===")

# PRUEBA 1: Unir listas
grupos = [
    ["Python", "Django"],
    ["Docker", "Linux"],
    ["PostgreSQL"]
]

anterior = [item for grupo in grupos for item in grupo]
nuevo = [*grupo for grupo in grupos]

assert anterior == nuevo

print("Listas:", nuevo)
print("Mismo resultado:", anterior == nuevo)


# PRUEBA 2: Unir conjuntos
etiquetas = [
    {"python", "backend"},
    {"backend", "devops"}
]

unicas = {*grupo for grupo in etiquetas}

print("Etiquetas sin duplicados:", sorted(unicas))


# PRUEBA 3: Combinar configuraciones
configuraciones = [
    {"host": "localhost", "debug": False},
    {"port": 8000},
    {"debug": True}
]

config = {**parte for parte in configuraciones}

print("Configuracion combinada:", config)
print("Ultimo valor debug:", config["debug"])

assert config["debug"] is True

print("EXPERIMENTO 04: CORRECTO")
¿Qué comprobamos con las nuevas comprensiones?
Ejecutamos los tres ejemplos utilizando Python 3.15.0 y verificamos que cada estructura se combinaba correctamente.
Obtuvimos Python, Django, Docker, Linux y PostgreSQL en una única lista plana.
La comparación con la comprensión tradicional devolvió True: ambos enfoques produjeron el mismo resultado.
Combinamos dos conjuntos que compartían la etiqueta backend. El resultado contuvo únicamente backend, devops y python.
Reunimos host, puerto y debug en un diccionario. Como debug aparecía dos veces, prevaleció el último valor: True.
Python 3.15 ofrece una forma adicional de expresar operaciones comunes sobre colecciones. No introduce una nueva estructura de datos: amplía la sintaxis disponible para construirlas.
La ventaja principal es la expresividad. En determinados casos, el código puede ser más directo y sencillo de comprender.
Sin embargo, una expresión más corta no significa necesariamente una ejecución más rápida. Para comparar rendimiento debemos medir ambas alternativas con datos representativos.
¿Cuándo es útil el desempaquetado en comprensiones?
Esta característica puede resultar útil al reunir resultados de distintas fuentes, combinar etiquetas, organizar configuraciones o transformar colecciones de datos.
Reunir elementos procedentes de múltiples grupos en una lista plana.
Obtener un conjunto que reúna valores procedentes de distintas colecciones sin duplicados.
Combinar varios mapeos, permitiendo que las entradas posteriores reemplacen valores de claves repetidas.
Las nuevas comprensiones con desempaquetado requieren Python 3.15. Si tu proyecto necesita funcionar en Python 3.12, 3.13 o 3.14, utiliza la sintaxis tradicional u otras alternativas compatibles.
Es importante diferenciar esta mejora del desempaquetado convencional. Los operadores * y ** ya existían en Python; la novedad consiste en ampliar los lugares donde pueden utilizarse dentro de comprensiones.
Con esto terminamos las mejoras relacionadas con las colecciones y pasamos a un cambio que afecta directamente al manejo de texto: el uso de UTF-8 por defecto.
NOVEDAD 05 · PEP 686
UTF-8 por defecto: menos problemas con tildes, eñes y emojis
Trabajar con archivos de texto parece una operación sencilla. Abrimos un archivo, leemos su contenido y continuamos procesando la información.
Sin embargo, durante años existió un problema frecuente: cuando no especificábamos una codificación, Python podía utilizar una diferente dependiendo del sistema operativo y su configuración regional.
Esto podía ocasionar que caracteres como á, é, í, ñ o ciertos emojis aparecieran incorrectamente al abrir archivos.
A partir de Python 3.15, el modo UTF-8 está habilitado de forma predeterminada. Al abrir archivos de texto sin indicar una codificación, Python utiliza UTF-8 en lugar de depender por defecto de la configuración regional.
UTF-8 es una codificación ampliamente utilizada para representar texto Unicode. Permite almacenar caracteres de diferentes idiomas y numerosos símbolos dentro de un formato común.
Sin especificar encoding, Python podía utilizar la codificación regional. En algunos sistemas Windows, esto provocaba diferencias al leer archivos UTF-8.
Python utiliza UTF-8 por defecto en las operaciones de texto correspondientes al modo UTF-8, reduciendo diferencias entre distintas plataformas.
Este cambio está definido en la PEP 686 — Make UTF-8 mode default .
La prueba: el mismo archivo en dos versiones de Python
Para comprobar este cambio utilizamos Python 3.12.10 y Python 3.15.0 instalados en la misma computadora.
Primero creamos un archivo de texto codificado en UTF-8. Su contenido era muy sencillo: una palabra con tilde, una palabra con ñ y un emoji de Python.
Guardamos exactamente estos caracteres y después abrimos el mismo archivo con ambas versiones del intérprete.
La diferencia es que no indicamos explícitamente una codificación al leer el archivo.
De esta forma pudimos observar cuál elegía cada versión en nuestro entorno Windows.
El comportamiento anterior a Python 3.15 depende de la configuración del equipo. Una instalación anterior también puede utilizar UTF-8 si se configura de manera explícita.
Comentarios y valoraciones
No hay comentarios aún. ¡Sé el primero en opinar!